 陈辅元
 Cursor
@@ -0,0 +1,40 @@
|
||||
Pages: 3
|
||||
Path: C:\Users\24019\Desktop\RAG-cut\docx\自研搭建AI助手知识库.pdf
|
||||
|
||||
============================================================
|
||||
PAGE 1 | images=1 text_blocks=17
|
||||
============================================================
|
||||
自研搭建AI助手知识库
|
||||
背景
|
||||
AFE有自建自有知识库功能,但知识库的切片效果不佳,存在两个问题:
|
||||
1、文档处理能力不足:包括word/pdf/excel文档中的图片、表格无法有效提取处理;
|
||||
2、切片规则不佳:如下图一段文本被强硬拆分在两个不同的片段;
|
||||
任务
|
||||
搭建一个AI助手知识库demo,能支持上传文件,查看切片效果;可以测试召回效果,查看召回入参和
|
||||
回参;
|
||||
目标
|
||||
目标:首要做好切片,其次是召回。
|
||||
支持文档类型:
|
||||
pdf、doc、docx、ppt、pptx、wps、ppsx
|
||||
xlsx、xls、csv、md、txt、html、json、xml、log
|
||||
jpg、png、jpeg、bmp、gif
|
||||
切片规则:
|
||||
表格文档:默认切分/按行切分
|
||||
其他文档:默认切分/通用标识符切分
|
||||
|
||||
============================================================
|
||||
PAGE 2 | images=2 text_blocks=6
|
||||
============================================================
|
||||
切片内表格:Markdown格式
|
||||
期望
|
||||
期望效果(基础):
|
||||
1. 图片展示在原文本展示的问题,不会丢失或者移动到其他位置
|
||||
2. 表格内容正确提取,并整理为markdown文本
|
||||
3. 切片规则合理,对于word至少同一个标题下的内容在一个切片中
|
||||
|
||||
============================================================
|
||||
PAGE 3 | images=4 text_blocks=3
|
||||
============================================================
|
||||
期望效果(高级):
|
||||
1. 对图片图形能够提取为图片,且识别文本信息转为文字
|
||||
2. 对pdf水平分布的栏目文本能够识别为正常顺序
|
||||
@@ -0,0 +1,103 @@
|
||||
# MinerU 解析层接入说明
|
||||
|
||||
RAG-cut 将 MinerU 作为可选的高质量文档解析后端,用于提升 PDF 的版面分析、OCR、图片/表格提取质量;切割策略仍由 RAG-cut 负责。
|
||||
|
||||
## 启用方式
|
||||
|
||||
默认模式:
|
||||
|
||||
```bash
|
||||
RAG_CUT_PDF_ENGINE=auto
|
||||
```
|
||||
|
||||
含义:
|
||||
|
||||
- 如果本机可用 `mineru` 或 `magic-pdf` 命令,优先调用 MinerU。
|
||||
- 如果 MinerU 未安装或解析失败,自动回退到现有 PyMuPDF/pdfplumber 管线。
|
||||
|
||||
强制使用 MinerU:
|
||||
|
||||
```bash
|
||||
RAG_CUT_PDF_ENGINE=mineru
|
||||
```
|
||||
|
||||
强制使用原 PyMuPDF 管线:
|
||||
|
||||
```bash
|
||||
RAG_CUT_PDF_ENGINE=pymupdf
|
||||
```
|
||||
|
||||
如果命令不在 PATH 中,可指定:
|
||||
|
||||
```bash
|
||||
RAG_CUT_MINERU_CMD=/path/to/mineru
|
||||
```
|
||||
|
||||
## 大文档推荐配置
|
||||
|
||||
`mineru` CLI 默认会为每次调用临时启动 API 和模型进程。处理页数较多的 Office/PDF
|
||||
文档时,建议单独启动一个常驻 MinerU API,避免重复加载模型。
|
||||
|
||||
先在一个终端启动服务:
|
||||
|
||||
```powershell
|
||||
python -m mineru.cli.fast_api --host 127.0.0.1 --port 30000
|
||||
```
|
||||
|
||||
再在启动 RAG-cut 后端的终端中配置并启动:
|
||||
|
||||
```powershell
|
||||
$env:RAG_CUT_MINERU_API_URL = "http://127.0.0.1:30000"
|
||||
$env:RAG_CUT_MINERU_TIMEOUT = "540"
|
||||
python backend/run.py
|
||||
```
|
||||
|
||||
未配置常驻 API 时,RAG-cut 仍可使用临时服务;若解析超时,会结束 MinerU 的完整
|
||||
进程树,避免模型子进程残留并拖慢后续请求。
|
||||
|
||||
## 数据流
|
||||
|
||||
```text
|
||||
PDF
|
||||
-> MinerU 解析 content_list.json / 图片资产
|
||||
-> 转换为 RAG-cut Block
|
||||
-> RAG-cut 自动判断 PDF 策略
|
||||
-> feature_step_screenshot 或 outline_report 切割
|
||||
-> Chunk + metadata + embedding_text
|
||||
```
|
||||
|
||||
## 统一 Block 映射
|
||||
|
||||
| MinerU 内容 | RAG-cut Block |
|
||||
| --- | --- |
|
||||
| title / heading / text_level | heading |
|
||||
| text | paragraph |
|
||||
| image / figure / **chart** / diagram / equation… | image(复制 img 资产) |
|
||||
| table(含可选截图) | table(markdown + 可选 image_path) |
|
||||
| code(有图则按图,否则按正文) | image / paragraph |
|
||||
| page_footnote | paragraph(`is_footnote`) |
|
||||
| header / footer / page_number | 丢弃 |
|
||||
|
||||
图片若无 MinerU OCR,默认用本地 Tesseract 回填(繁体优先):
|
||||
|
||||
```bash
|
||||
RAG_CUT_MINERU_OCR=1 # 默认开启;设为 0 可关闭以加快大批量切分
|
||||
```
|
||||
|
||||
保留字段:
|
||||
|
||||
- page
|
||||
- bbox
|
||||
- image_path
|
||||
- ocr_text
|
||||
- caption
|
||||
- mineru_type
|
||||
- parser=mineru
|
||||
|
||||
## 设计原则
|
||||
|
||||
MinerU 只提升解析质量,不决定 chunk 语义边界。不同文档类型的切割仍由 RAG-cut 策略层处理:
|
||||
|
||||
- 操作手册:功能章节 + 操作步骤 + 截图区域
|
||||
- 年报/研报:章节报告
|
||||
- 表格:表头 + 行组
|
||||

Binary file not shown.
|
After Width: | Height: | Size: 366 KiB |

Binary file not shown.
|
After Width: | Height: | Size: 304 KiB |

Binary file not shown.
|
After Width: | Height: | Size: 629 KiB |
@@ -0,0 +1,189 @@
|
||||
# 腾讯云智能体开发平台:文档切分设置
|
||||
|
||||
> 来源页面:[腾讯云文档 - 文档切分设置](https://cloud.tencent.com/document/product/1759/122551)
|
||||
> 页面最近更新时间:2025-12-31 16:49:32
|
||||
> 整理说明:本文为根据页面内容整理的 Markdown 版,保留核心概念、功能入口、规则对比和关键参数说明,并非网页原文逐字复制。
|
||||
|
||||
## 1. 功能概述
|
||||
|
||||
文档切分是指系统按照一定规则,将上传到知识库的文档拆分为多个独立切片。切片会被索引并存储,是 RAG(Retrieval-Augmented Generation,检索增强生成)流程中的关键环节。
|
||||
|
||||
在问答场景中,系统通常会先根据用户问题检索相关切片,再把命中的切片作为外部知识放入大模型上下文,从而辅助模型生成答案。
|
||||
|
||||
切分粒度会直接影响检索质量和回答效果:
|
||||
|
||||
- 切片过大:容易包含无关内容,降低检索精度,也会增加上下文和计算资源消耗。
|
||||
- 切片过小:上下文不完整,知识片段更碎片化,可能导致回答不够全面。
|
||||
- 合理切分:需要在检索效率、上下文完整性和生成质量之间取得平衡。
|
||||
|
||||
## 2. 切分规则类型
|
||||
|
||||
平台支持两类文档切分方式:
|
||||
|
||||
- 默认切分规则:由平台使用模型能力自动切分,用户不能直接干预具体规则。
|
||||
- 自定义切分规则:用户可根据业务需求设置切分方式,主要包括通用标识符切分、父子标识符切分和按行切分。
|
||||
|
||||
## 3. 切分规则对比
|
||||
|
||||
| 切分方式 | 适用文档类型 | 典型使用场景 | 核心逻辑 |
|
||||
|---|---|---|---|
|
||||
| 默认切分 | 平台支持导入的全部文档类型 | 对切分无特殊要求的知识库文档 | 基于切分模型处理,关注语义完整性、复杂元素解析和表格处理 |
|
||||
| 通用标识符切分 | 非表格类文档,不包括 xlsx、xls、csv | 需要按页码、自定义符号或业务段落进行切分 | 用户设置标识符、最大长度和重叠长度,切片同时用于检索和召回 |
|
||||
| 父子标识符切分 | 非表格类文档,不包括 xlsx、xls、csv | 检索粒度和召回粒度需要分离的场景 | 子级切片用于检索,命中后召回对应父级切片给大模型 |
|
||||
| 按行切分 | 表格类文档,包括 xlsx、xls、csv | 表格每行或每几行相对独立,如商品 SKU 文档 | 用户设置表头范围、起始行和每个切片包含的行数 |
|
||||
|
||||
## 4. 默认切分能力
|
||||
|
||||
默认切分由平台模型完成,适合大多数不需要精细控制切片边界的文档。
|
||||
|
||||
平台默认切分能力包括:
|
||||
|
||||
- 支持按语义完整性切分。
|
||||
- 支持跨页表格合并。
|
||||
- 支持解析表格中的图片信息。
|
||||
- 支持解析有线表格和无线表格。
|
||||
- 支持解析数据图、流程图、架构图、思维导图。
|
||||
- 支持处理多栏、公式、子图等复杂版式元素。
|
||||
|
||||
## 5. 功能入口
|
||||
|
||||
### 入口一:上传文档时设置
|
||||
|
||||
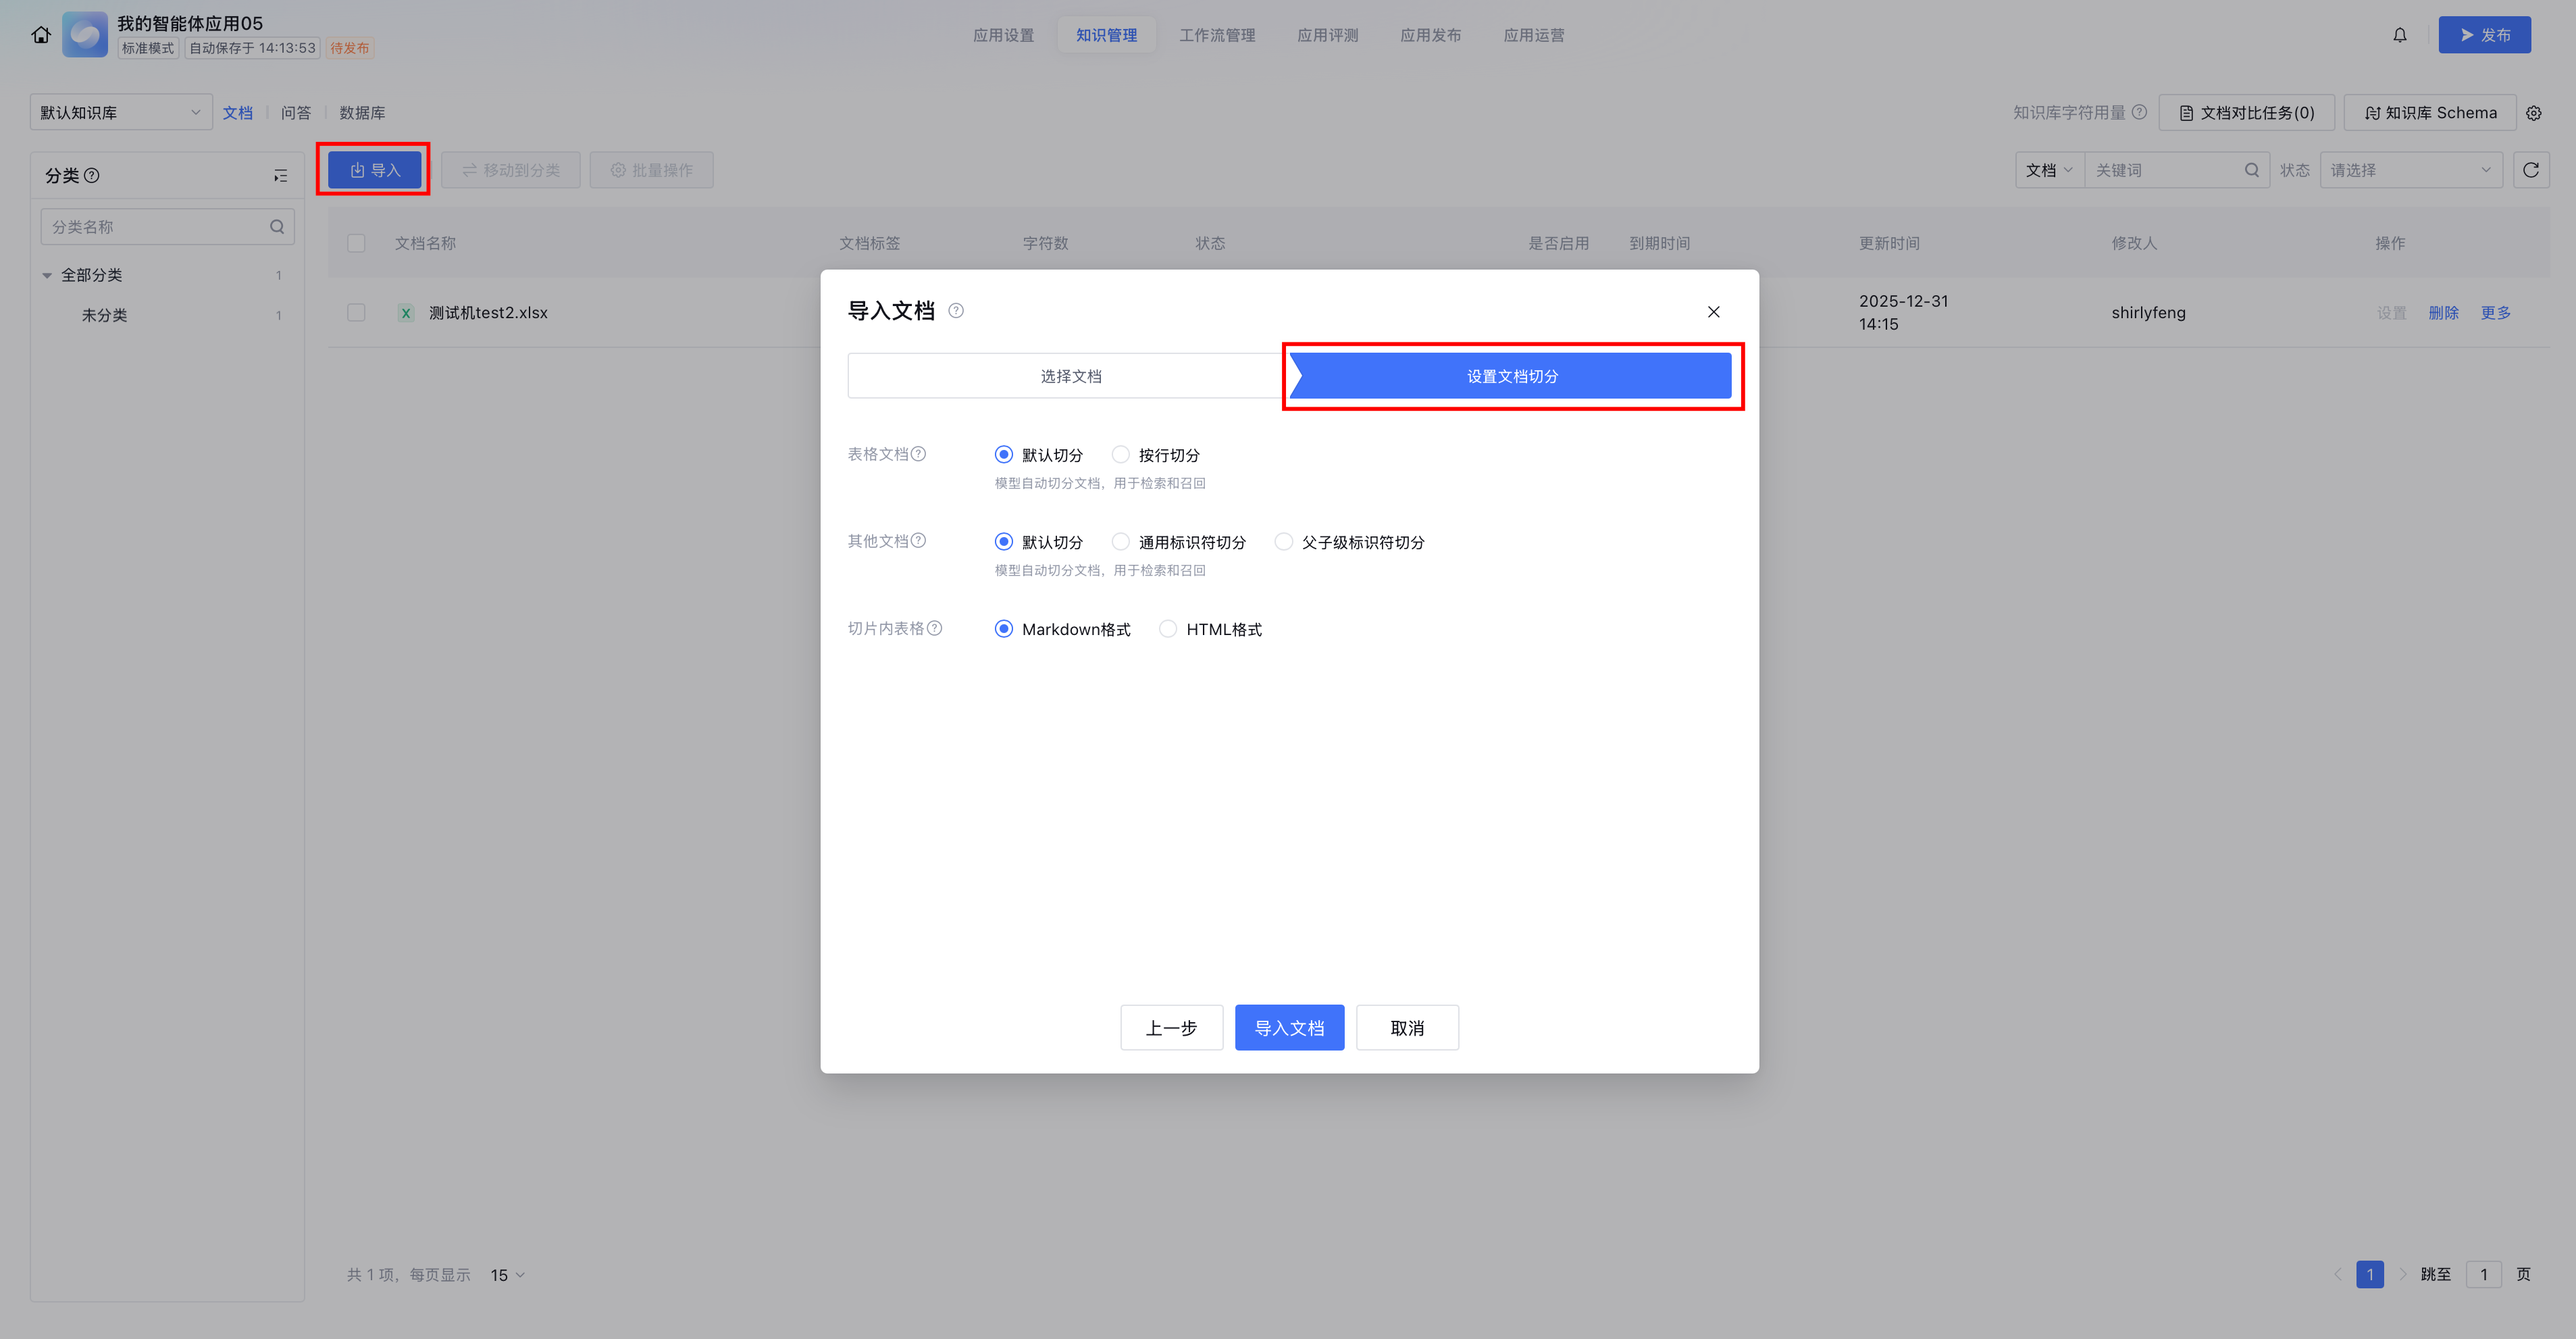
在知识库中上传文档时,流程通常包括:
|
||||
|
||||
1. 上传文档。
|
||||
2. 设置文档切片。
|
||||
3. 按文档类型对同一批上传文档生效。
|
||||
|
||||
图示来源:
|
||||
|
||||
|
||||
|
||||
### 入口二:已导入文档重新设置
|
||||
|
||||
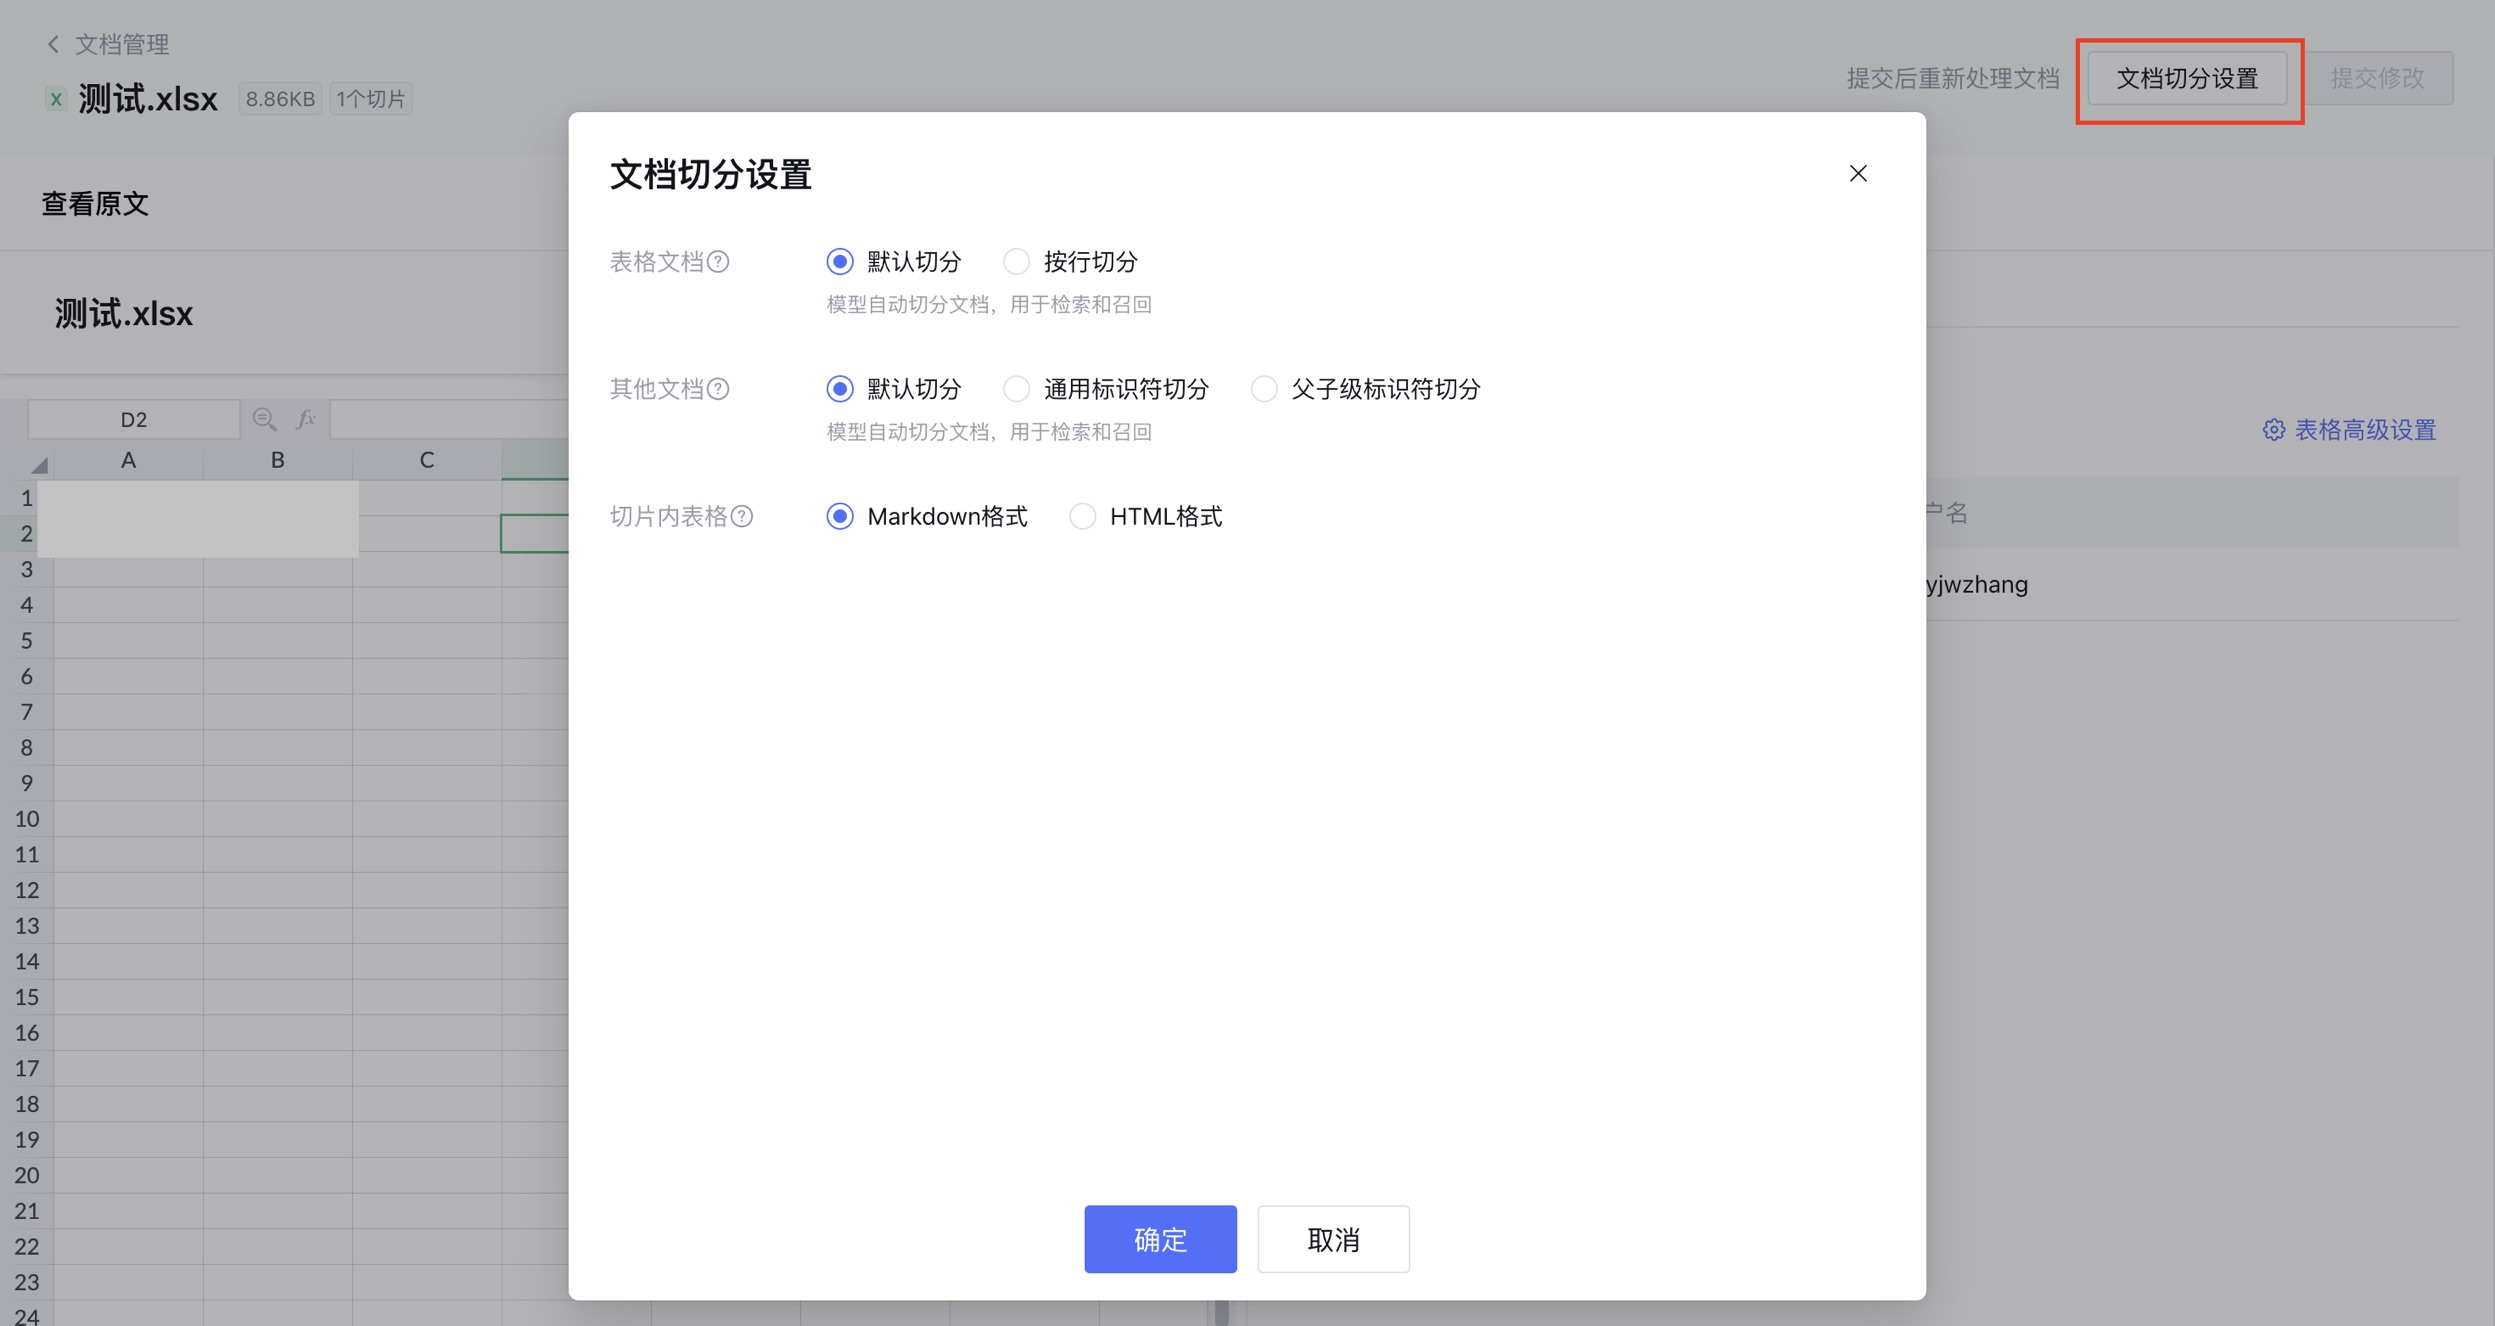
对已经导入知识库的文档,可以重新设置切分规则:
|
||||
|
||||
1. 进入知识库。
|
||||
2. 找到指定文档。
|
||||
3. 点击文档右侧的“更多”。
|
||||
4. 选择“解析切分干预”。
|
||||
5. 查看解析切分结果。
|
||||
6. 点击“文档切分设置”重新配置切分规则。
|
||||
|
||||
图示来源:
|
||||
|
||||

|
||||
|
||||
|
||||
|
||||
注意:重新设置文档切分规则后,系统会按照原文档重新切分,并覆盖之前干预过的切分结果。
|
||||
|
||||
## 6. 表格文档切分
|
||||
|
||||
表格类文档包括 xlsx、xls、csv。平台对表格文档支持默认切分和按行切分。
|
||||
|
||||
### 6.1 默认切分
|
||||
|
||||
默认切分会使用平台切分模型,根据表格行数、语义完整性等因素自动处理。
|
||||
|
||||
### 6.2 按行切分
|
||||
|
||||
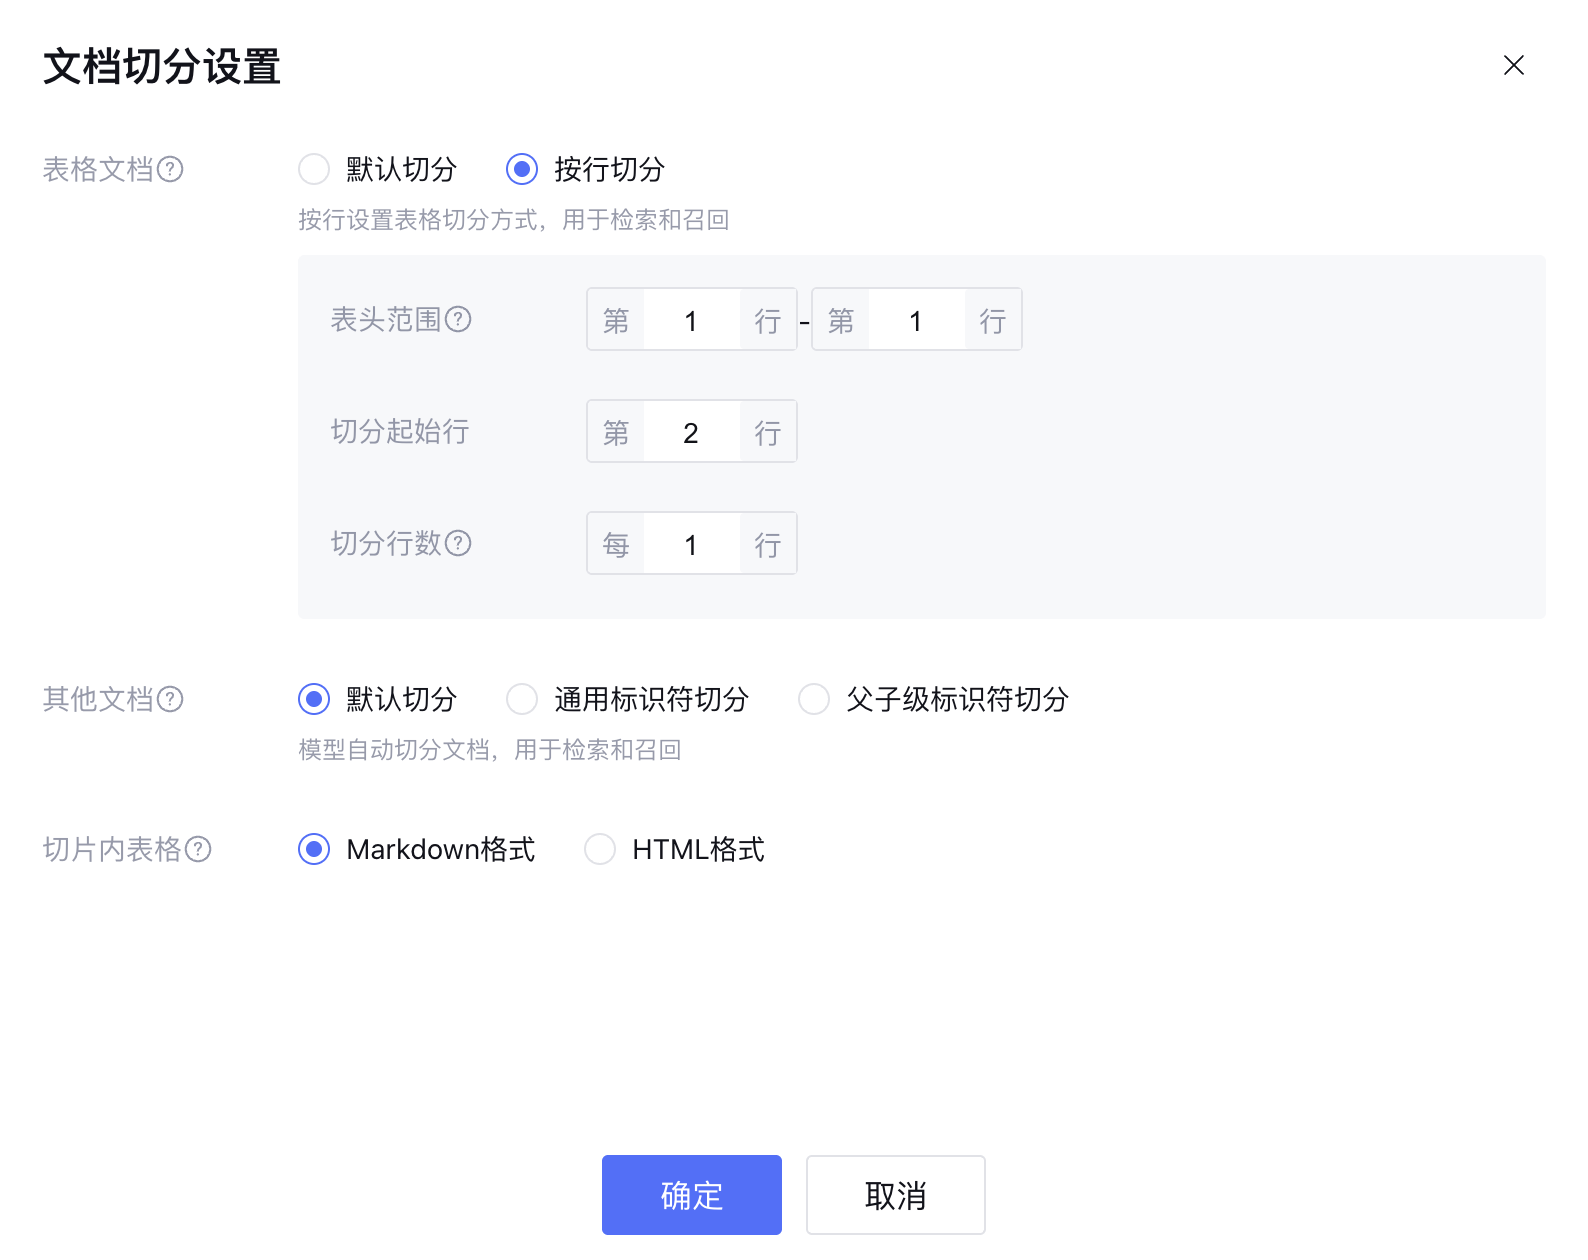
按行切分适合每行或每几行数据相对独立的表格,例如商品 SKU 表、配置清单、结构化数据表等。
|
||||
|
||||
关键参数如下:
|
||||
|
||||
| 参数 | 说明 |
|
||||
|---|---|
|
||||
| 表头范围 | 选择表格中的表头行,每个切片都会包含表头数据;区间最大支持 5 行 |
|
||||
| 切分起始行 | 指定从哪一行开始切分;起始行不能与表头范围重复 |
|
||||
| 切分行数 | 指定每个切片从起始行开始包含多少行数据 |
|
||||
|
||||
示例:如果表头为第 1 行,切分起始行为第 2 行,切分行数为 1,则第一个切片为“表头 + 第 2 行”,第二个切片为“表头 + 第 3 行”,依此类推。
|
||||
|
||||
图示来源:
|
||||
|
||||
|
||||
|
||||
## 7. 非表格文档切分
|
||||
|
||||
非表格类文档指知识库中除 xlsx、xls、csv 之外的文档类型。平台支持默认切分、通用标识符切分和父子级标识符切分。
|
||||
|
||||
### 7.1 默认切分
|
||||
|
||||
默认切分会使用平台切分模型,根据语义完整性进行自动切分。
|
||||
|
||||
### 7.2 通用标识符切分
|
||||
|
||||
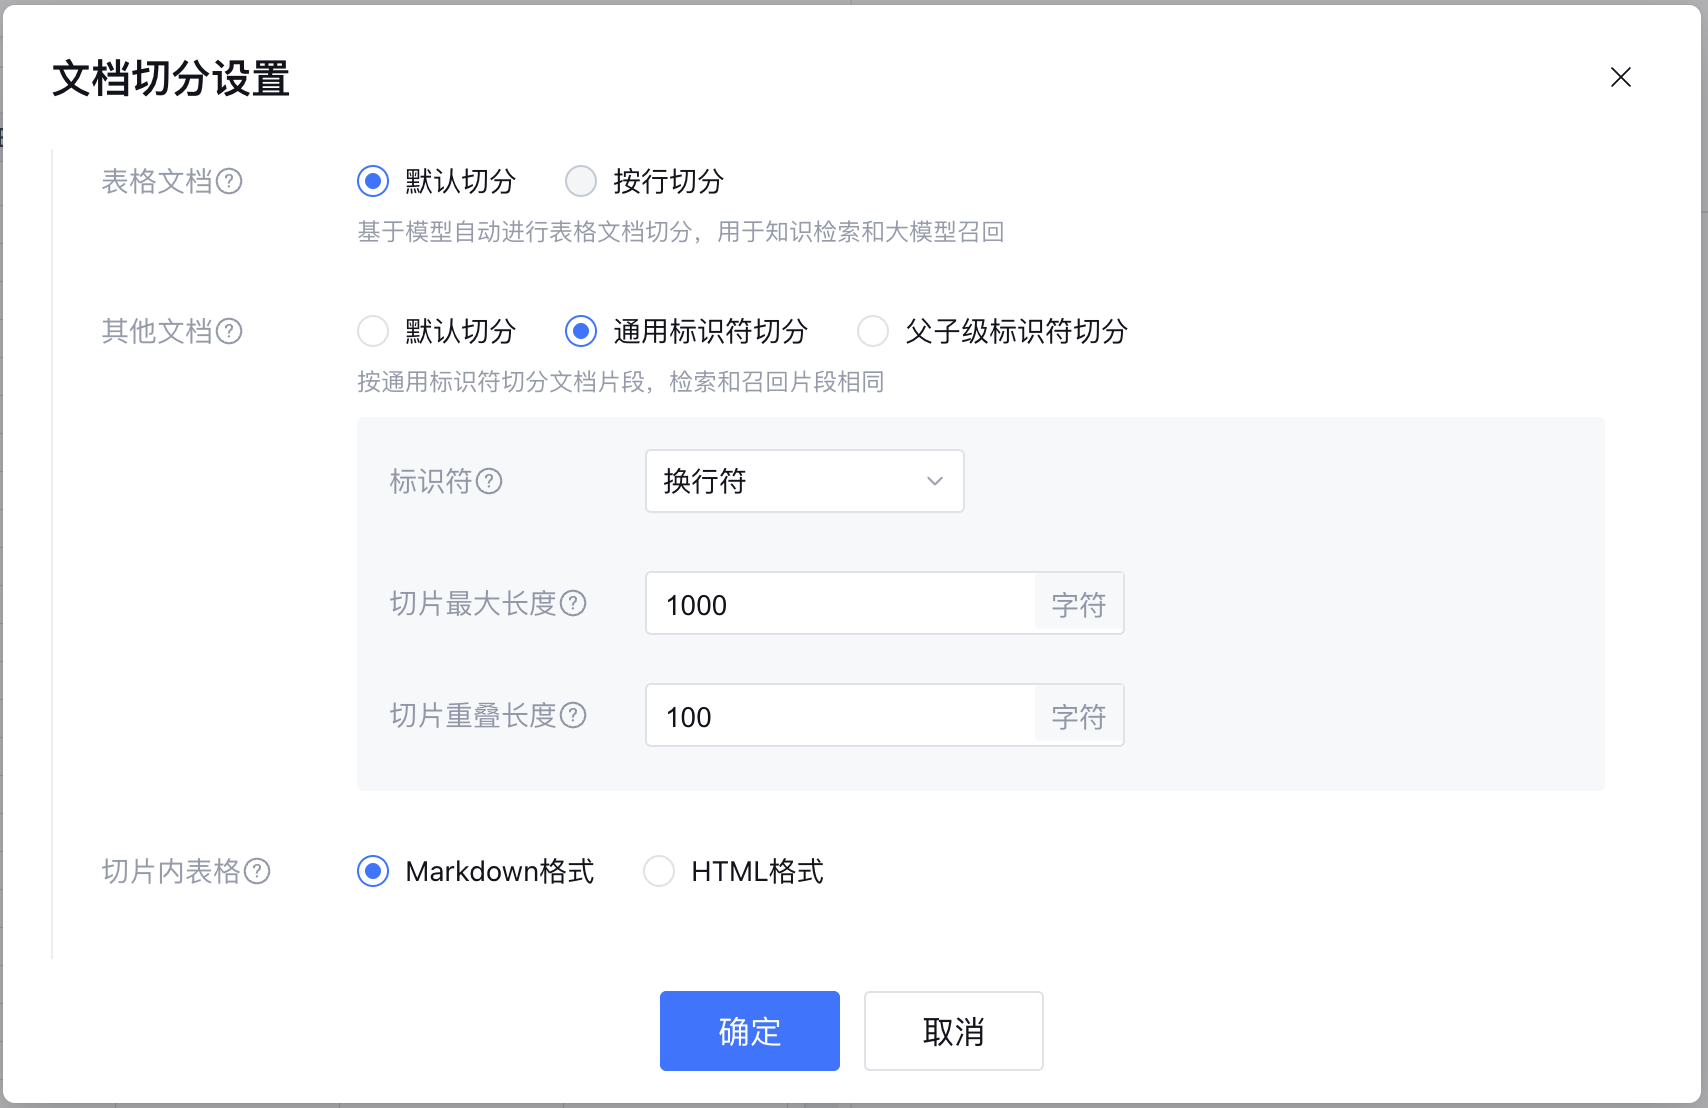
通用标识符切分适合需要按特定符号或业务结构拆分文档的场景,例如按照 `###`、`***`、章节分隔符或自定义标记切分。
|
||||
|
||||
关键参数如下:
|
||||
|
||||
| 参数 | 说明 |
|
||||
|---|---|
|
||||
| 标识符 | 系统按照用户设置的标识符切分文档;切分标识符不会出现在最终切片中 |
|
||||
| 切分最大长度 | 每个切片允许的最大字符数;如果按标识符切出的片段超过最大长度,会继续按长度拆分;最大不超过 4800 字符 |
|
||||
| 切分重叠长度 | 当片段超过最大长度需要继续拆分时,保留相邻切片之间的重叠字符,用于维持语义连续性 |
|
||||
|
||||
设置建议:
|
||||
|
||||
- 切分重叠长度可设置为切分最大长度的约 10%。
|
||||
- 切分重叠长度最高可设置为切分最大长度的 25%。
|
||||
|
||||
图示来源:
|
||||
|
||||
|
||||
|
||||
### 7.3 父子级标识符切分
|
||||
|
||||
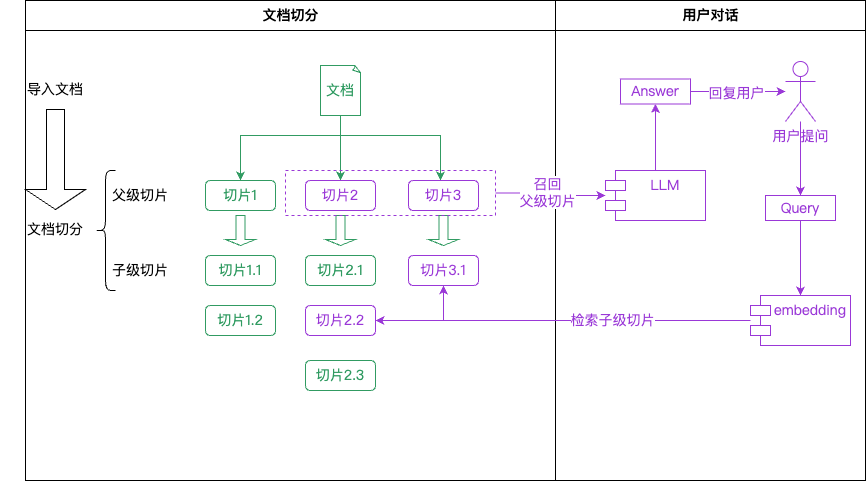
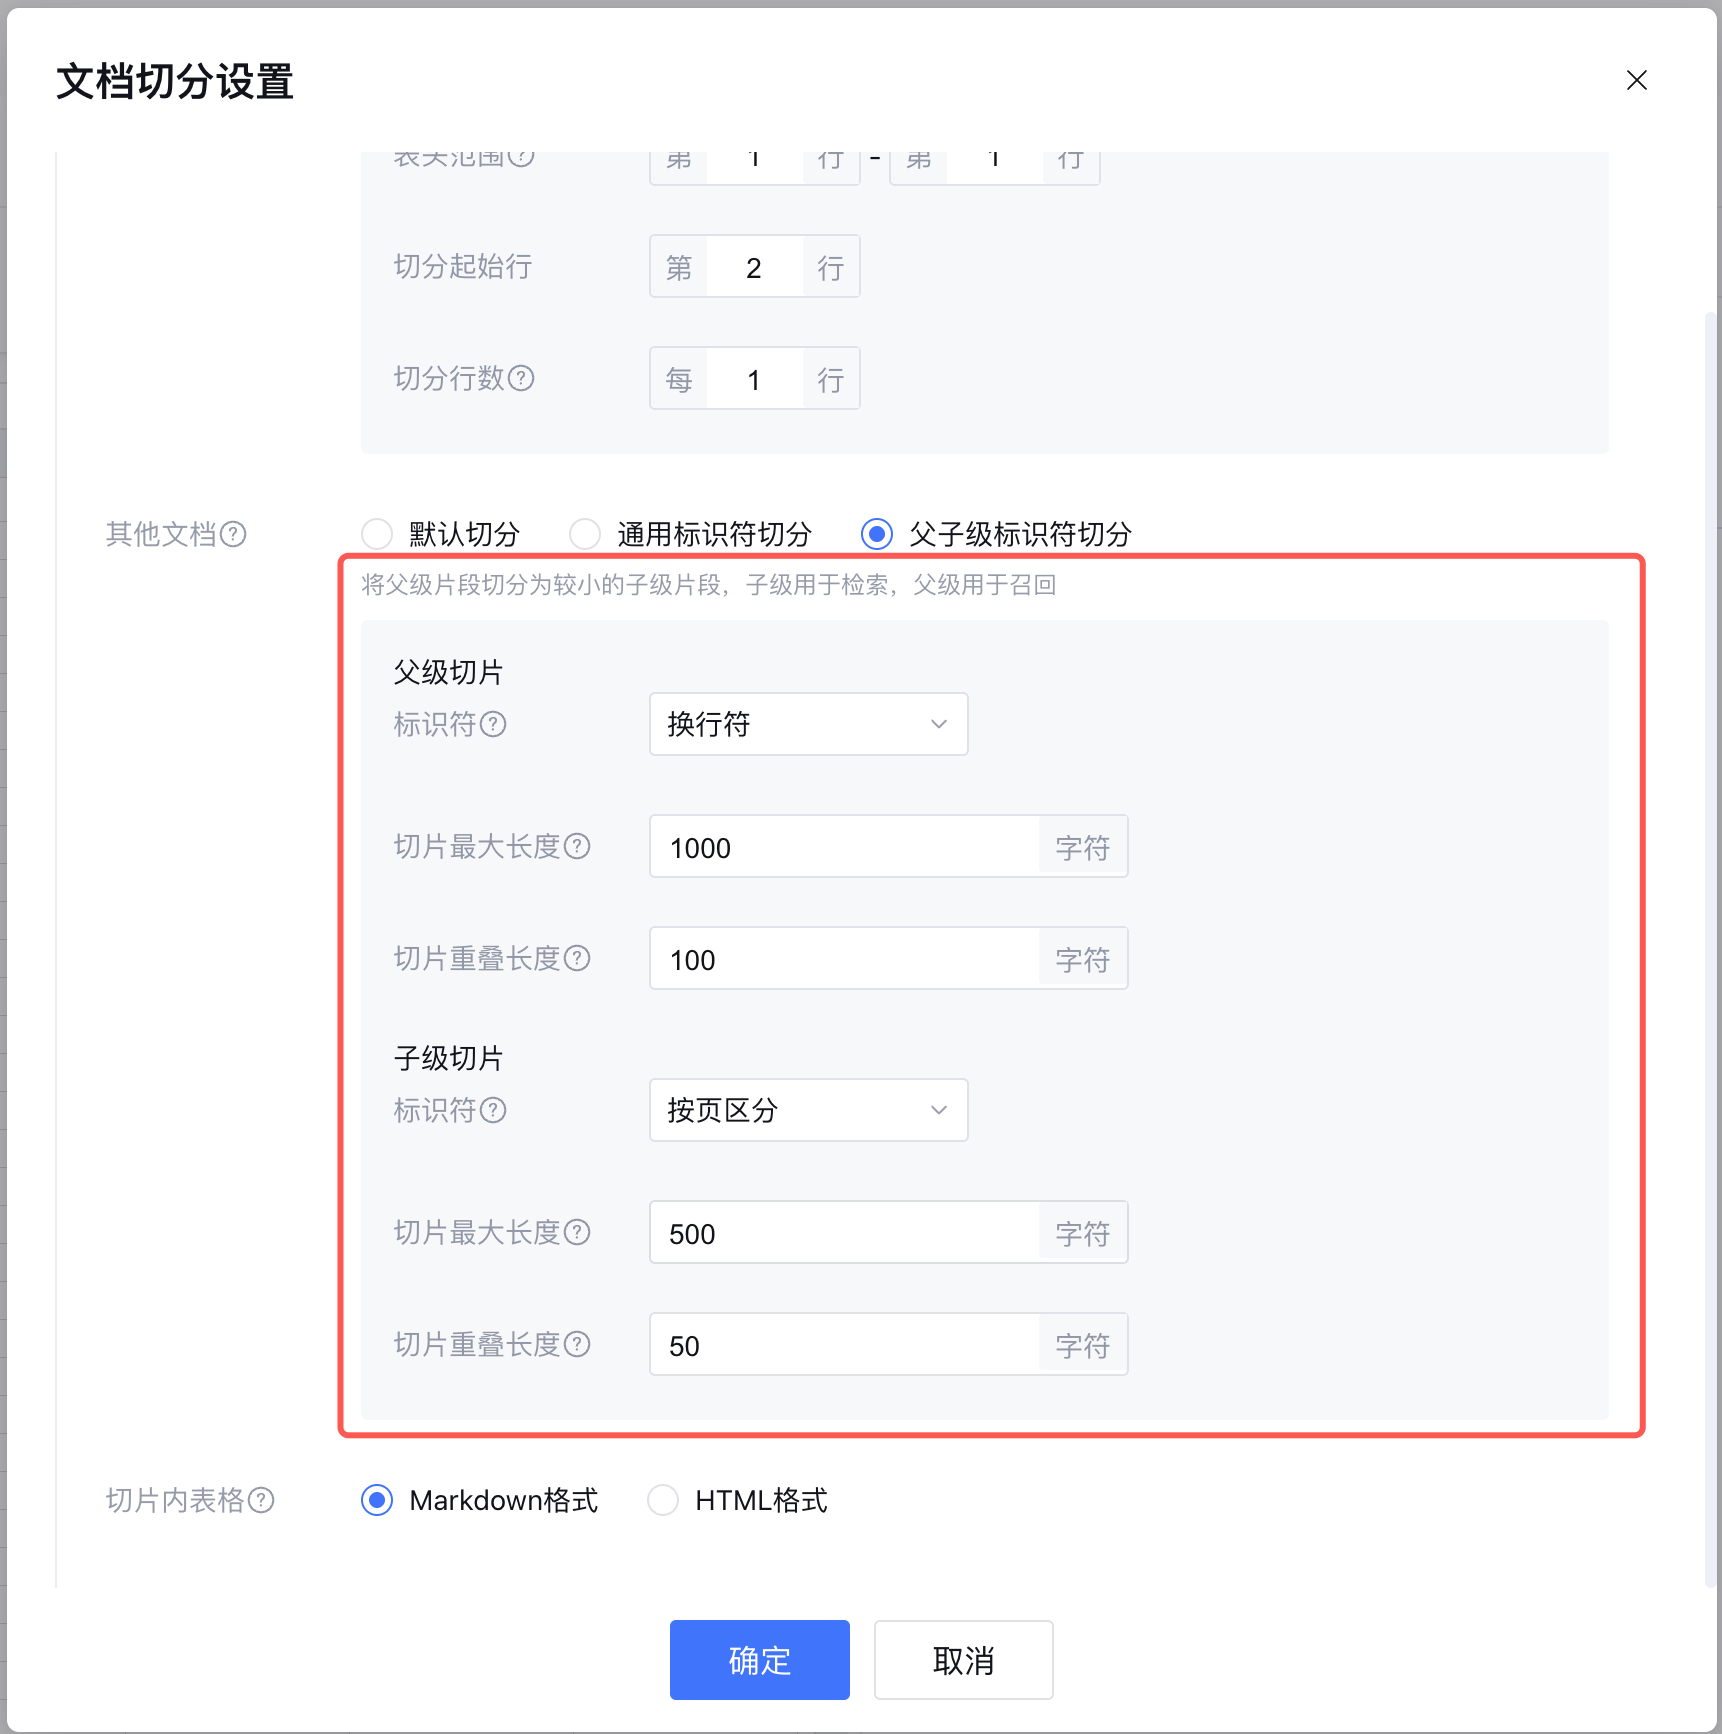
父子级标识符切分适合需要“细粒度检索、粗粒度召回”的知识库场景。系统会先把文档拆成父级切片,再把父级切片拆成一个或多个子级切片。
|
||||
|
||||
工作方式:
|
||||
|
||||
1. 用户问题先检索子级切片。
|
||||
2. 命中子级切片后,系统找到对应父级切片。
|
||||
3. 父级切片被召回给大模型用于答案生成。
|
||||
|
||||
这种方式的优点是:
|
||||
|
||||
- 子级切片更短,有利于提升检索精度。
|
||||
- 父级切片保留更多上下文,有利于提高生成答案的完整性。
|
||||
|
||||
约束条件:
|
||||
|
||||
- 子级切片最大长度不能超过父级切片最大长度。
|
||||
- 子级切片最大可设置为 1500 字符。
|
||||
- 子级切片与父级切片是一对一或多对一关系。
|
||||
|
||||
图示来源:
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
## 8. 切分内表格格式
|
||||
|
||||
平台支持设置文档中表格内容的切片格式:
|
||||
|
||||
| 格式 | 特点 |
|
||||
|---|---|
|
||||
| Markdown 格式 | 默认格式,通常效果更好,便于模型理解表格结构 |
|
||||
| HTML 格式 | token 消耗相对更少 |
|
||||
|
||||
该设置对普通文档中的表格内容,以及表格文档中的内容均可生效。
|
||||
|
||||
## 9. 使用建议
|
||||
|
||||
| 场景 | 推荐切分方式 |
|
||||
|---|---|
|
||||
| 普通知识库文档,无特殊切分要求 | 默认切分 |
|
||||
| 文档结构清晰,有固定章节、页码或分隔符 | 通用标识符切分 |
|
||||
| 希望检索更精准,同时召回更完整上下文 | 父子级标识符切分 |
|
||||
| 表格每行是独立数据,如商品、配置、SKU | 按行切分 |
|
||||
| 文档表格较多,且希望模型更好理解结构 | Markdown 表格格式 |
|
||||
| token 成本敏感,表格结构不复杂 | HTML 表格格式 |
|
||||
|
||||
## 10. 相关页面
|
||||
|
||||
- 上一篇:文档概述
|
||||
- 下一篇:解析切分干预
|
||||
- 原始页面:[文档切分设置](https://cloud.tencent.com/document/product/1759/122551)
|
||||
Binary file not shown.
Reference in New Issue
Block a user